Avant de commencer 5 questions pour vérifier tes bases Ton parcours dans ce chapitre Un même tableau peut répondre à plusieurs questions. Pour ne pas les confondre, on nomme d’abord le groupe étudié, puis on choisit son total de référence.
Bases à reprendre : une fréquence est un effectif divisé par celui du groupe choisi. Par exemple, \(3/12=25\,\%\) . On travaille avec un effectif total \(N>0\) ; une fréquence conditionnelle demande aussi un groupe de référence non vide. Chaque pause donne accès librement à deux indices puis à l’explication.
Repères 2026–2027 : tableaux croisés, fréquences marginales et conditionnelles, filtres logiques et interprétation de données. Le fichier Iris donne une enquête réelle à explorer. Les formules générales de pondération, l’indépendance descriptive, le paradoxe de Simpson et la standardisation sont des prolongements guidés.
Pourquoi croiser deux variables ? Une statistique à une variable répond à une question comme : « quelle proportion d'élèves arrive à l'heure ? ». Croiser deux variables permet d'aller plus loin : cette proportion est-elle la même selon le mode de transport ? Le tableau croisé sert à organiser les couples d'informations observés sur les mêmes individus.
Intuition · Un tableau qui répond à plusieurs questions
Chaque case intérieure décrit une intersection : des individus vérifient simultanément deux critères. Les marges décrivent les groupes entiers. Changer de dénominateur change la question posée.
Exemple · Une enquête de ponctualité
On interroge 160 élèves. Pour chacun, on relève son mode de transport et s'il est arrivé à l'heure. Le croisement permettra de comparer les taux de ponctualité entre les modes de transport.
Attention · Observer n'est pas expliquer
Si deux variables semblent liées, le tableau établit une association , pas nécessairement une cause. La distance au lycée, l'horaire ou d'autres facteurs peuvent influencer simultanément le transport et la ponctualité.
Variables qualitatives et modalités Nominale ou ordinale
Définition · Variable qualitative
Une variable est qualitative lorsque ses valeurs sont des catégories appelées modalités .
Elle est nominale si les catégories n'ont pas d'ordre naturel : couleur, moyen de transport.
Elle est ordinale si les catégories peuvent être ordonnées : faible, moyen, élevé.
Exemple · Reconnaître la nature
Le mode de transport est qualitatif nominal. Un degré de satisfaction « insatisfait, neutre, satisfait » est qualitatif ordinal. L'âge exact est quantitatif ; une tranche d'âge est qualitative ordinale.
Attention · Les nombres peuvent être des étiquettes
Un numéro de département ou un code postal n'est pas une grandeur mesurable : calculer sa moyenne n'a pas de sens. Ce sont des catégories, même si elles sont écrites avec des chiffres.
À toi d’essayer
Des nombres peuvent servir d’étiquettes On relève un code postal et un nombre de trajets hebdomadaires. Pour quelle variable une moyenne a-t-elle un sens ? Peut-on coder « marche », « vélo », « bus » par \(1,2,3\) sans rendre la variable quantitative ?
Tu peux chercher, prendre un indice ou lire l’explication, à ton rythme.
Indice 1 · Une piste Une opération arithmétique doit conserver un sens dans la situation étudiée.
Indice 2 · Un pas de plus Changer les codes des transports ne change pas les transports eux-mêmes.
Voir l’explication Le nombre de trajets est une quantité : sa moyenne décrit un nombre moyen par individu. Les codes postaux et les codes \(1,2,3\) sont des étiquettes ; les additionner ne donne pas une mesure de transport. À réessayer : explique pourquoi les catégories « pas satisfait, neutre, satisfait » sont ordonnées sans être automatiquement espacées régulièrement.
Un individu fournit un couple
Si l'on observe deux variables \(X\) et \(Y\) , chaque individu fournit un couple
\[\bigl(X(\text{individu}),Y(\text{individu})\bigr).\]
Par exemple, un élève peut fournir le couple (transports en commun, à l'heure).
Le produit cartésien rassemble les couples possibles
Définition · Deux ensembles, des couples ordonnés
Pour deux ensembles \(E\) et \(F\) , le produit cartésien \(E\times F\) est l'ensemble des couples \((e,f)\) dont la première composante appartient à \(E\) et la seconde à \(F\) .
L'ordre porte une information : dans (bus, en retard), on lit d'abord le transport, puis la ponctualité. Inverser les deux composantes change leur rôle.
Exemple · Quatre cases possibles ne signifient pas quatre personnes
Prenons \(E=\{\text{vélo},\text{bus}\}\) et \(F=\{\text{à l'heure},\text{en retard}\}\) . Les quatre couples possibles sont :
À l'heure En retard Vélo (vélo, à l'heure) (vélo, en retard) Bus (bus, à l'heure) (bus, en retard)
Chaque choix dans \(E\) s'associe aux deux choix dans \(F\) : on compte \(2\times2=4\) couples. En général, pour des ensembles finis,
\[\operatorname{Card}(E\times F)=\operatorname{Card}(E)\,\operatorname{Card}(F).\]
Si une liste contient trois personnes, deux venues en bus à l'heure et une venue à vélo en retard, elle contient trois individus mais seulement deux couples distincts observés. Les deux autres cases restent possibles ; leur effectif observé vaut zéro. La liste des cases n'impose aucune équiprobabilité.
À toi d’essayer
Séparer les modalités, les couples et les individus On note un transport dans \(E=\{\text{bus},\text{vélo},\text{marche}\}\) et un moment dans \(F=\{\text{matin},\text{soir}\}\) . Énumère \(E\times F\) . Trois observations donnent (bus, matin), (bus, matin), (vélo, soir). Combien a-t-on de couples possibles, de couples distincts observés et d'individus ? Une case vide est-elle impossible ?
Tu peux chercher, prendre un indice ou lire l’explication, à ton rythme.
Indice 1 · Une piste Pour chaque transport, écris les deux moments. Puis compte les observations sans supprimer les répétitions.
Indice 2 · Un pas de plus Le produit cartésien contient \(3\times2\) couples. Une répétition compte comme une nouvelle observation, mais ne crée pas un nouveau couple distinct.
Voir l’explication Les couples possibles sont (bus, matin), (bus, soir), (vélo, matin), (vélo, soir), (marche, matin), (marche, soir) : il y en a \(6\) .
La liste contient \(3\) individus et seulement \(2\) couples distincts observés. La case (bus, matin) a l'effectif \(2\) , la case (vélo, soir) a l'effectif \(1\) , les quatre autres ont l'effectif \(0\) . Un zéro dans ce fichier ne prouve pas que la combinaison est impossible. À réessayer : ajoute le moment « midi ». Le produit possède désormais \(3\times3=9\) couples, même avant toute nouvelle observation. Si l'un des deux ensembles n'a aucune modalité, aucun couple ne peut être formé : le produit est vide.
Construire et lire un tableau croisé Cases intérieures et marges
Définition · Tableau croisé d'effectifs
Un tableau croisé répartit les individus selon deux variables qualitatives.
Une case intérieure contient l'effectif d'une combinaison de deux modalités.
Les effectifs marginaux sont les totaux des lignes et des colonnes.
La case en bas à droite contient l'effectif total \(N\) .
Exemple · Transport et ponctualité
Actif Transports Motorisé Total À l'heure 42 58 24 124 En retard 8 12 16 36 Total 50 70 40 160
« 42 » signifie : 42 élèves utilisent un transport actif et arrivent à l'heure.
Propriété · Retrouver les marges
Chaque total de ligne est la somme des cases de sa ligne ; chaque total de colonne est la somme des cases de sa colonne. Par exemple,
\[42+58+24=124,
\qquad
42+8=50.\]
Une preuve à construire
Pourquoi les deux sommes des marges valent-elles \(N\) ? Pourquoi additionner les marges de lignes, puis les marges de colonnes, donnerait-il \(2N\) et non \(N\) ?
Tu peux chercher, prendre un indice ou lire l’explication, à ton rythme.
Indice 1 · Une piste Chaque observation appartient à une ligne et à une colonne.
Indice 2 · Un pas de plus Chacune des deux sommes compte déjà toute la population une fois.
Voir la preuve expliquée Chaque individu est compté une fois dans exactement une modalité de la première variable. La somme des totaux de lignes compte donc tous les individus une fois. Le même raisonnement s'applique aux colonnes :
\[\sum_i n_{i\bullet}=N
\qquad\text{et}\qquad
\sum_j n_{\bullet j}=N.\]
À toi d’essayer
Une case peut-elle être négative ? Un groupe de \(30\) personnes contient \(12\) réponses « oui » et \(20\) réponses « non ». Chaque personne devait donner une seule réponse. Le tableau est-il possible ? Comment le vérifier sans calculer de pourcentage ?
Tu peux chercher, prendre un indice ou lire l’explication, à ton rythme.
Indice 1 · Une piste Additionne les deux cases intérieures.
Indice 2 · Un pas de plus Le total des cases doit être celui du groupe, et chaque effectif est un entier positif ou nul.
Voir l’explication Les cases totalisent \(32\) , ce qui contredit \(30\) . Ce n’est pas une difficulté de pourcentage : le comptage ou la définition des catégories doit être repris. On ne peut pas inventer une correction sans information. À réessayer : si le total \(30\) et les \(12\) « oui » sont confirmés, le nombre de « non » est \(18\) .
Le langage des ensembles
Notons \(A\) l'ensemble des élèves utilisant un transport actif et \(H\) l'ensemble des élèves arrivés à l'heure. Alors
\[\operatorname{Card}(A)=50,\qquad
\operatorname{Card}(H)=124,\qquad
\operatorname{Card}(A\cap H)=42.\]
Intuition · Le mot « et »
Une case intérieure correspond toujours à une intersection. « Actif et à l'heure » signifie \(A\cap H\) . Le mot « ou » correspondrait à une réunion, qui n'est généralement pas une seule case du tableau.
Propriété · Cardinal d'une réunion
Pour deux ensembles \(A\) et \(B\) ,
\[\boxed{\operatorname{Card}(A\cup B)
=\operatorname{Card}(A)+\operatorname{Card}(B)-\operatorname{Card}(A\cap B)}.\]
Une preuve à construire
Pourquoi soustraire l'intersection ? Pourquoi faut-il enlever une fois l’intersection pour compter le « ou » inclusif ?
Tu peux chercher, prendre un indice ou lire l’explication, à ton rythme.
Indice 1 · Une piste Suis une personne qui appartient aux deux groupes.
Indice 2 · Un pas de plus Elle apparaît déjà deux fois dans la somme des deux effectifs.
Voir la preuve expliquée En additionnant \(\operatorname{Card}(A)\) et \(\operatorname{Card}(B)\) , les individus de \(A\cap B\) sont comptés deux fois. On retire donc une fois leur effectif pour que chaque individu de \(A\cup B\) soit compté exactement une fois.
Fréquences globales et marginales Fréquence d'une case
Définition · Fréquence globale
La fréquence globale d'une case est son effectif divisé par l'effectif total :
\[\boxed{f(A\cap B)=\frac{\operatorname{Card}(A\cap B)}{N}}.\]
Dans l'exemple,
\[\begin{aligned}f(A\cap H) &= \frac{42}{160}\\[.35em]&= 0{,}2625\\[.35em]&= \boxed{26{,}25\,\%}.\end{aligned}\]
Cela signifie que 26,25 % de tous les élèves sont à la fois utilisateurs d'un transport actif et ponctuels.
Fréquence marginale
Définition · Fréquence marginale
La fréquence marginale d'une modalité est son effectif marginal divisé par \(N\) :
\[f(A)=\frac{\operatorname{Card}(A)}{N}.\]
Ainsi,
\[\begin{aligned}f(A) &= \frac{50}{160}\\[.35em]&= 31{,}25\,\%,\\[.35em]f(H) &= \frac{124}{160}\\[.35em]&= 77{,}5\,\%.\end{aligned}\]
Démonstration · Une marge est la somme de ses cases
Les catégories de ponctualité « à l'heure » et « en retard » partagent l'ensemble \(A\) sans chevauchement. Donc
\[\begin{aligned}f(A) &= f(A\cap H)+f(A\cap\overline H)\\[.35em]&= \frac{42}{160}+\frac8{160}\\[.35em]&= \frac{50}{160}.\end{aligned}\]
À toi d’essayer
Trois fractions, trois phrases Dans le tableau des transports, interprète \(42/160\) , \(50/160\) et \(42/50\) . Laquelle utilise seulement le groupe des transports actifs ?
Tu peux chercher, prendre un indice ou lire l’explication, à ton rythme.
Indice 1 · Une piste Le dénominateur \(160\) désigne toute l’enquête.
Indice 2 · Un pas de plus La case \(42\) croise actif et à l’heure ; la marge \(50\) totalise les actifs.
Voir l’explication \(42/160=26{,}25\,\%\) décrit ceux qui sont actifs et à l’heure dans l’ensemble. \(50/160=31{,}25\,\%\) décrit la marge des actifs. \(42/50=84\,\%\) décrit la ponctualité parmi les actifs. À réessayer : formule la question correspondant à \(8/36\) .
Fréquences conditionnelles Le dénominateur est le groupe après « parmi »
Définition · Fréquence de \(B\) parmi \(A\)
Si \(A\) n'est pas vide, la fréquence de \(B\) parmi les individus de \(A\) est
\[\boxed{f_A(B)=\frac{\operatorname{Card}(A\cap B)}{\operatorname{Card}(A)}}.\]
Le groupe \(A\) est appelé groupe de référence ou groupe conditionnant.
Exemple · Ponctualité parmi les transports actifs
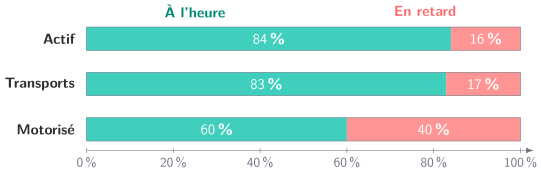
Parmi les 50 élèves utilisant un transport actif, 42 arrivent à l'heure :
\[\begin{aligned}f_A(H) &= \frac{42}{50}\\[.35em]&= 0{,}84\\[.35em]&= \boxed{84\,\%}.\end{aligned}\]
Le dénominateur est 50, et non 160, car la question commence par « parmi les utilisateurs d'un transport actif ».
Intuition · Zoomer sur une sous-population
Calculer \(f_A(B)\) revient à oublier momentanément tous les individus qui ne sont pas dans \(A\) . Le groupe \(A\) devient alors le nouveau « tout », donc son effectif devient le dénominateur.
L'ordre change la question
Attention · Inverser change la question
\[\begin{aligned}f_A(B) &=\frac{\operatorname{Card}(A\cap B)}{\operatorname{Card}(A)},\\[.35em]f_B(A) &=\frac{\operatorname{Card}(A\cap B)}{\operatorname{Card}(B)}.\end{aligned}\]
Si les deux groupes sont non vides, le numérateur est le même, mais les dénominateurs peuvent différer. Les valeurs peuvent aussi être égales, par exemple lorsque les deux groupes ont le même effectif ; cela ne rend pas les questions identiques.
Exemple · Deux questions, deux réponses
\[f_A(H)=\frac{42}{50}=84\,\%,
\qquad
f_H(A)=\frac{42}{124}\approx33{,}9\,\%.\]
84 % des utilisateurs d'un transport actif sont ponctuels, mais seulement 33,9 % des élèves ponctuels utilisent un transport actif. Ces phrases ne se contredisent pas.
À toi d’essayer
Le même groupe peut donner deux taux égaux Dans une population, \(A\) et \(B\) contiennent chacun \(20\) individus, dont \(8\) communs. Calcule \(f_A(B)\) et \(f_B(A)\) . Si \(B\) contient ensuite \(40\) individus avec les mêmes \(8\) communs, que devient chaque taux ?
Tu peux chercher, prendre un indice ou lire l’explication, à ton rythme.
Indice 1 · Une piste Le numérateur reste \(8\) dans chaque calcul.
Indice 2 · Un pas de plus Le taux « parmi \(A\) » garde \(20\) au dénominateur.
Voir l’explication Au départ, les deux taux valent \(8/20=40\,\%\) , bien que leurs questions diffèrent. Dans la nouvelle population, \(f_A(B)=40\,\%\) et
\[\begin{aligned}f_B(A) &= 8/40\\[.35em]&= 20\,\%\end{aligned}.\]
À réessayer : si \(A\) est vide, explique pourquoi \(f_A(B)\) n’est ni \(0\) ni \(1\) , mais non définie.
Tableaux de fréquences conditionnelles
Si l'on conditionne par le mode de transport, chaque colonne devient un groupe de référence et totalise 100 %.
Actif Transports Motorisé À l'heure \(42/50=84\,\%\) \(58/70\approx82{,}9\,\%\) \(24/40=60\,\%\) En retard \(8/50=16\,\%\) \(12/70\approx17{,}1\,\%\) \(16/40=40\,\%\) Total 100 % 100 % 100 %
Attention · Ne pas mélanger les dénominateurs
Dans un même tableau conditionnel, les pourcentages d'une colonne doivent tous utiliser le même total de colonne. Additionner des pourcentages calculés sur des groupes de référence différents n'a pas de sens.
Attention aux arrondis : des parts affichées à un chiffre après la virgule peuvent totaliser \(99{,}9\,\%\) ou \(100{,}1\,\%\) . Vérifie les effectifs ou les fractions exactes avant de conclure à une erreur.
Reconstruire une fréquence globale
Théorème · Moyenne pondérée des fréquences conditionnelles
Si \(A_1,\ldots,A_k\) forment une partition en groupes non vides d’une population de taille \(N>0\) , alors
\[\boxed{f(B)=\sum_{i=1}^{k}f(A_i)\,f_{A_i}(B)}.\]
Une preuve à construire
Décomposer la population Pourquoi les tailles des groupes servent-elles de poids dans la fréquence globale ?
Tu peux chercher, prendre un indice ou lire l’explication, à ton rythme.
Indice 1 · Une piste Exprime le nombre de personnes vérifiant \(B\) dans chacun des groupes.
Indice 2 · Un pas de plus Additionne ces effectifs disjoints, puis divise par le total \(N\) .
Voir la preuve expliquée Comme les groupes \(A_i\) sont disjoints et couvrent toute la population,
\[\operatorname{Card}(B)=\sum_i\operatorname{Card}(A_i\cap B).\]
Or
\[\begin{aligned}\operatorname{Card}(A_i\cap B) &= \operatorname{Card}(A_i)\,f_{A_i}(B)\\[.35em]&= Nf(A_i)f_{A_i}(B).\end{aligned}\]
En divisant la première égalité par \(N\) , on obtient la formule.
Exemple · Retrouver la ponctualité globale
\[\begin{aligned}f(H) &= \frac{50}{160}\times0{,}84 +\frac{70}{160}\times\frac{58}{70}\\[.35em]&\quad {}+\frac{40}{160}\times0{,}60\\[.35em]&= \frac{124}{160}\\[.35em]&= 77{,}5\,\%.\end{aligned}\]
La fréquence globale est une moyenne pondérée : les groupes les plus nombreux pèsent davantage.
À toi d’essayer
La taille des groupes compte Un groupe de \(10\) personnes compte \(8\) réponses « oui » ; un groupe de \(90\) personnes en compte \(18\) . Calcule le taux global. Pourquoi la moyenne simple de \(80\,\%\) et \(20\,\%\) ne convient-elle pas ?
Tu peux chercher, prendre un indice ou lire l’explication, à ton rythme.
Indice 1 · Une piste Réunis les individus avant de diviser.
Indice 2 · Un pas de plus Les deux groupes ne contribuent pas le même nombre de réponses.
Voir l’explication On compte \(8+18=26\) « oui » parmi \(100\) personnes, soit \(26\,\%\) . La moyenne simple \(50\,\%\) donnerait un poids égal à deux groupes de tailles très différentes. Les poids corrects sont \(10/100\) et \(90/100\) . À réessayer : compare avec deux groupes de \(50\) personnes aux mêmes taux ; le total devient \(50\,\%\) .
Compléter un tableau croisé À partir des marges
Méthode · Raisonner ligne par ligne
Pour retrouver une case manquante, soustrais les cases connues au total de sa ligne ou de sa colonne. Termine par un contrôle sur l'effectif total.
Exemple · Une case manquante
\(B\) \(\overline B\) Total \(A\) 36 ? 60 \(\overline A\) 24 16 40 Total 60 40 100
La case manquante vaut \(60-36=24\) . On vérifie aussi \(24+16=40\) dans la deuxième colonne.
À partir d'une fréquence conditionnelle
Propriété · Revenir à un effectif
Si \(f_A(B)=p\) , alors
\[\operatorname{Card}(A\cap B)=p\times\operatorname{Card}(A).\]
Exemple · Utiliser 35 %
Parmi 240 personnes abonnées, 35 % choisissent l'option premium. L'effectif correspondant est
\[0{,}35\times240=\boxed{84}.\]
Le pourcentage s'applique à 240, car les abonnés constituent le groupe de référence.
Attention · Un contrôle d'intégralité
Un effectif est un entier. Si un calcul donne \(26{,}4\) personnes, les données sont arrondies, incohérentes ou incomplètes. Il faut alors le signaler plutôt que masquer le problème.
À toi d’essayer
Un pourcentage ne suffit pas sans son total Une enquête porte sur \(200\) personnes. Le groupe \(A\) en contient \(80\) . Parmi \(A\) , \(25\,\%\) vérifient \(B\) . Au total \(70\) vérifient \(B\) . Retrouve les quatre cases.
Tu peux chercher, prendre un indice ou lire l’explication, à ton rythme.
Indice 1 · Une piste Commence par \(25\,\%\) des \(80\) personnes de \(A\) .
Indice 2 · Un pas de plus Complète le reste de chaque ligne et colonne par soustraction.
Voir l’explication Les cases de la ligne \(A\) sont \(20\) et \(60\) . Hors \(A\) , elles sont \(70-20=50\) et \(120-50=70\) . Les lignes totalisent \(80\) et \(120\) , les colonnes \(70\) et \(130\) . À réessayer : si le total de \(B\) était annoncé égal à \(10\) , explique l’impossibilité : l’intersection en contient déjà \(20\) .
Représenter et comparer les groupes Barres empilées à 100 %
Pour comparer des groupes de tailles différentes, on représente leurs fréquences conditionnelles sur des barres de même longueur.
Agrandir ↗ Intuition · Comparer des proportions, pas des hauteurs brutes
La largeur verte répond directement à la question « quelle part du groupe est ponctuelle ? ». Des barres d'effectifs pourraient surtout refléter que certains groupes sont plus nombreux.
Manipuler les proportions d’un groupe
La manipulation suivante représente \(100\) objets fictifs : \(10\) dans \(A\) , dont \(8\) marqués \(B\) , et \(90\) hors \(A\) , dont \(18\) marqués \(B\) . On peut vérifier les comptes sur papier : \(8/10=80\,\%\) parmi \(A\) , contre \(8/26\approx30{,}77\,\%\) de \(A\) parmi \(B\) . Changer de groupe pour comprendre « sachant que »
Sur 100 objets, 10 sont dans le groupe A. Parmi A, 80 % portent la marque B ; parmi les autres, 20 % portent B. Prévois combien des objets portant B appartiennent à A.
Le rectangle représente exactement 100 objets. À gauche : le groupe A. Les zones bleues portent B ; les zones claires ne portent pas B. Les surfaces sont proportionnelles aux effectifs.
Parmi A, 8 objets sur 10 portent B. Hors A, 18 sur 90 portent B. Parmi les 26 objets portant B, 8 appartiennent donc à A : 8/26 ≈ 30,77 %, tandis que 8/10 = 80 %.
Lire les valeurs et les coordonnées Parmi A, 8 objets sur 10 portent B. Hors A, 18 sur 90 portent B. Parmi les 26 objets portant B, 8 appartiennent donc à A : 8/26 ≈ 30,77 %, tandis que 8/10 = 80 %.
Garde les deux parts de B fixes et augmente la taille de A. Explique pourquoi la part de A parmi les objets portant B change. Pour calculer une probabilité conditionnelle, quel groupe devient ton total de référence ?
\(100\) objets, tandis qu’une barre normalisée à \(100\,\%\) représente son propre groupe.
Choisir la bonne représentation
À toi d’essayer
Deux barres égales peuvent cacher deux effectifs Deux barres empilées à \(100\,\%\) montrent chacune \(60\,\%\) de « oui ». Les groupes contiennent \(10\) et \(1000\) personnes. Ont-ils le même nombre de « oui » ? Quelles informations faut-il garder sur le graphique ?
Tu peux chercher, prendre un indice ou lire l’explication, à ton rythme.
Indice 1 · Une piste La hauteur normalisée compare des proportions.
Indice 2 · Un pas de plus Applique \(60\,\%\) à chacun des deux effectifs.
Voir l’explication Les nombres de « oui » sont \(6\) et \(600\) . Les parts sont identiques mais les effectifs diffèrent d’un facteur \(100\) . Il faut afficher le total de chaque groupe et annoncer l’axe en pourcentage. À réessayer : explique ce qui changerait avec un diagramme de nombres de réponses « oui » : les hauteurs ne seraient plus égales.
Comparer et interpréter sans se tromper Écart en points de pourcentage
Dans l'exemple, l'écart de ponctualité entre les transports actifs et motorisés vaut
\[84\,\%-60\,\%=\boxed{24\ \text{points de pourcentage}}.\]
Dire « 24 % de plus » serait ambigu : un écart de proportions se formule de préférence en points.
À toi d’essayer
Nommer le point de départ d’une comparaison Un taux passe de \(60\,\%\) à \(72\,\%\) . Calcule l’écart en points et l’évolution relative. Puis fais le trajet inverse.
Tu peux chercher, prendre un indice ou lire l’explication, à ton rythme.
Indice 1 · Une piste Un écart en points est une différence de proportions exprimées en pourcentage.
Indice 2 · Un pas de plus Le dénominateur de l’évolution relative est le taux de départ ; il change au retour.
Voir l’explication L’aller représente \(12\) points et \((72-60)/60=20\,\%\) d’augmentation relative. Au retour, l’écart est \(-12\) points mais le taux vaut \((60-72)/72=-1/6\) , soit environ \(-16{,}67\,\%\) . À réessayer : pourquoi l’évolution relative à partir de \(0\,\%\) n’est-elle pas définie par cette formule ?
Association et causalité
Définition · Association observée
Deux variables sont associées dans les données lorsque les fréquences conditionnelles changent sensiblement d'un groupe à l'autre.
Attention · Une association ne prouve pas une cause
Le tableau ne permet pas d'affirmer que choisir un transport actif cause la ponctualité. Il manque des informations sur la distance, les horaires, la météo et la manière dont les données ont été recueillies.
Filtrer des données avec la logique et Python ET, OU, NON
Propriété · Traduction ensembliste
\[\text{ET}\longleftrightarrow\cap,\qquad
\text{OU}\longleftrightarrow\cup,\qquad
\text{NON }A\longleftrightarrow\overline A.\]
Le « ou » mathématique est inclusif : \(A\cup B\) contient aussi les individus qui vérifient les deux critères.
Exemple · Filtrer une base
« Élèves en transports en commun ET en retard » sélectionne la case d'effectif 12. « Transport actif OU à l'heure » sélectionne \(A\cup H\) , d'effectif
\[50+124-42=\boxed{132}.\]
Explorer un fichier réel : les iris
Le jeu Iris , version UCI, contient \(150\) observations et trois espèces de \(50\) observations chacune. On croise l’espèce avec une catégorie construite à partir de la longueur du pétale : « moins de \(4{,}5\) cm » ou « \(4{,}5\) cm et plus ». La mesure est quantitative ; sa classe devient une catégorie ordonnée.
Espèce \(<4{,}5\) cm\(\geqslant4{,}5\) cmTotal setosa 50 0 50 versicolor 29 21 50 virginica 0 50 50 Total 79 71 150
Refaire le comptage : télécharge le fichier CSV des 150 observations . Dans ton tableur, ouvre-le avec le séparateur point-virgule ; chaque ligne est un individu. Filtre l’espèce, puis la classe de longueur, et compte les lignes restantes. Compare les six comptes au tableau, puis change le seuil à \(5\) cm. Garde ensemble les cellules d’une même ligne lorsque tu tries.
Source : R. Fisher, Iris (1936), UCI Machine Learning Repository , DOI 10.24432/C56C76, licence CC BY 4.0 . Le fichier pédagogique sélectionne deux colonnes, ajoute une catégorie et conserve les 150 observations de iris.data. Les précisions de source et d’adaptation sont fournies avec le CSV.
Ces proportions décrivent ce fichier équilibré entre espèces, pas la répartition des iris dans la nature. Les zéros du tableau ne prouvent pas une impossibilité biologique ; le seuil est notre choix de classement.
À toi d’essayer
Une vraie donnée, deux conditionnements Dans le tableau Iris, quelle part des versicolor a un pétale d’au moins \(4{,}5\) cm ? Parmi les pétales d’au moins \(4{,}5\) cm, quelle part appartient à virginica ? Peut-on en conclure que virginica est l’espèce la plus fréquente dans la nature ?
Tu peux chercher, prendre un indice ou lire l’explication, à ton rythme.
Indice 1 · Une piste Le premier groupe de référence contient \(50\) observations, le second \(71\) .
Indice 2 · Un pas de plus Les cases cherchées contiennent respectivement \(21\) et \(50\) .
Voir l’explication Les parts sont \(21/50=42\,\%\) et \(50/71\approx70{,}42\,\%\) . Le fichier comprend volontairement autant d’observations par espèce ; il ne mesure pas leurs abondances naturelles. À réessayer : avec le CSV et un seuil strict \(5\) cm, les effectifs sous le seuil sont \(50,48,6\) et au-dessus ou à égalité \(0,2,44\) . Retrouve une fréquence dans chaque sens.
Construire le tableau à partir de listes
transports = ["actif", "commun", "actif", "motorise"]
ponctuels = [True, True, False, False]

effectif = 0
if len(transports) != len(ponctuels):
    raise ValueError("listes de memes longueurs attendues")

for t, h in zip(transports, ponctuels):
    if t == "actif" and h:
        effectif = effectif + 1

print(effectif)
zip associe les valeurs de même rang. Si les deux listes ont des longueurs différentes, il s’arrête à la plus courte : le contrôle précédent évite de perdre silencieusement des individus. La syntaxe est fournie pour lire le filtrage ; le tableur permet de faire la même exploration sans programmer.
Méthode · Lire le programme
La boucle examine chaque individu. La condition avec and traduit une intersection. Pour construire tout le tableau, on initialise un compteur par combinaison de modalités puis on incrémente exactement une case par individu.
Attention · Données manquantes
Une valeur vide ne doit pas être confondue avec une modalité réelle. Avant de compter, vérifie comment les absences de réponse sont codées et décide explicitement si tu les exclus ou si tu crées une modalité « non renseigné ».
Du tableau statistique au modèle probabiliste Intuition · Un pont, pas encore tout le chapitre
Si l'on choisit uniformément un individu parmi les 160 élèves, chaque fréquence devient la probabilité d'un évènement dans ce modèle d'équiprobabilité. La prochaine fiche étudiera systématiquement les probabilités conditionnelles et les arbres.
Avec \(A=\) « transport actif » et \(H=\) « à l'heure »,
\[P(A)=\frac{50}{160},\qquad
P(A\cap H)=\frac{42}{160},\qquad
P_A(H)=\frac{42}{50}.\]
La même fraction apparaît, mais son statut change : dans l'enquête, elle décrit une fréquence observée ; dans le modèle, elle devient une probabilité.
Attention · Le modèle doit être annoncé
Une probabilité n'est pas automatiquement une fréquence passée. On choisit un modèle en explicitant ses hypothèses, notamment la manière dont l'individu est sélectionné.
Pour aller plus loin - Accessible à tous Intuition · Statut de cette partie
Les idées suivantes prolongent l’étude des tableaux. Elles sont facultatives et leurs justifications sont détaillées ; on peut aussi revenir au parcours principal à tout moment.
Indépendance observée
Définition · Critère descriptif
Dans un tableau, on dit que les variables paraissent indépendantes lorsque la distribution d'une variable est la même dans chaque groupe de l'autre variable. Par exemple,
\[f_A(B)=f(B).\]
Il s'agit ici d'un constat sur les données, pas d'une vérité universelle sur la population.
Exemple · Indépendance parfaite dans un tableau
\(B\) \(\overline B\) Total \(A\) 30 20 50 \(\overline A\) 30 20 50 Total 60 40 100
Dans chaque ligne, la fréquence de \(B\) vaut 60 %, comme dans toute la population.
Le test du produit en croix pour un tableau \(2\times2\)
Considérons le tableau
\[\begin{array}{c|cc}
& B & \overline B\\ \hline
A & a & b\\
\overline A & c & d
\end{array}.\]
Théorème · Critère \(ad=bc\)
Pour des effectifs positifs ou nuls avec \(a+b>0\) et \(c+d>0\) , les deux lignes ont la même fréquence de \(B\) si et seulement si
\[\boxed{ad=bc}.\]
Une preuve à construire
Un simple produit en croix Justifie le critère \(ad=bc\) . Pourquoi demande-t-on que chacune des deux lignes soit non vide ?
Tu peux chercher, prendre un indice ou lire l’explication, à ton rythme.
Indice 1 · Une piste Les dénominateurs sont les totaux de lignes \(a+b\) et \(c+d\) .
Indice 2 · Un pas de plus Après le produit en croix, le terme \(ac\) apparaît des deux côtés.
Voir la preuve expliquée Les fréquences de \(B\) dans les deux lignes sont \(a/(a+b)\) et \(c/(c+d)\) . Alors
\[\begin{aligned}\frac{a}{a+b} &= \frac{c}{c+d}\\[.35em]&\ssi a(c+d)\\[.35em]&= c(a+b)\\[.35em]&\ssi ac+ad=ac+bc\\[.35em]&\ssi \boxed{ad=bc}.\end{aligned}\]
Le paradoxe de Simpson
Exemple · Un renversement surprenant
On compare la réussite avec ou sans tutorat dans deux niveaux initiaux.
Avec tutorat Sans tutorat Groupe initial 1 \(18/20=90\,\%\) \(80/100=80\,\%\) Groupe initial 2 \(60/100=60\,\%\) \(5/10=50\,\%\) Ensemble \(78/120=65\,\%\) \(85/110\approx77{,}3\,\%\)
Le tutorat est associé à un meilleur taux dans chaque niveau, mais à un taux global plus faible. Ce renversement s'explique par la composition des groupes : le groupe tutoré contient beaucoup plus d'élèves du second groupe initial.
Intuition · Pourquoi le global peut-il tromper ?
Chaque taux global est une moyenne pondérée des taux par niveau. Les poids ne sont pas les mêmes dans les deux groupes. Comparer les seuls taux globaux mélange donc l'effet du niveau initial et l'association avec le tutorat.
À toi d’essayer
Comparer aussi la composition des groupes Dans l’exemple du tutorat, le taux est plus élevé dans chacun des deux niveaux et plus faible globalement. Est-ce contradictoire ? Que se passe-t-il si les deux taux de chaque niveau sont comparés avec les mêmes poids \(1/2\) ?
Tu peux chercher, prendre un indice ou lire l’explication, à ton rythme.
Indice 1 · Une piste Les effectifs par niveau ne sont pas les mêmes dans les groupes tutorés et non tutorés.
Indice 2 · Un pas de plus Compare \(\tfrac12(90+60)\) et \(\tfrac12(80+50)\) , en pourcentage.
Voir l’explication On obtient \(75\,\%\) et \(65\,\%\) . Le résultat global initial ne contredit pas les résultats détaillés : il utilisait des poids différents. La standardisation neutralise ici ce seul facteur ; elle ne prouve pas l’effet causal du tutorat. À réessayer : donne au premier niveau un poids \(1/4\) dans les deux groupes. Les taux deviennent \(67{,}5\,\%\) et \(57{,}5\,\%\) , toujours séparés de \(10\) points.
Standardiser pour comparer avec les mêmes poids
Si l'on donne artificiellement le même poids \(1/2\) aux deux niveaux, les taux standardisés deviennent
\[\text{tutorat}:\ \frac12\times90\,\%+\frac12\times60\,\%=75\,\%,\]
\[\text{sans tutorat}:\ \frac12\times80\,\%+\frac12\times50\,\%=65\,\%.\]
Cette comparaison descriptive neutralise la différence de composition. Elle ne prouve toujours pas une causalité, mais elle évite une partie du piège.
Boîte à outils et erreurs à éviter Méthode · Case intérieure
Intersection de deux modalités.
Méthode · Fréquence conditionnelle
\[f_A(B)=n(A\cap B)/n(A).\]
Attention · Réflexes
Vérifie les marges, les dénominateurs, la somme 100 % et évite toute causalité automatique.
Intuition · La question qui sauve
Avant chaque pourcentage, demande-toi : « parmi quel groupe ? ». Si tu connais ce groupe, tu connais le dénominateur.
Exercices progressifs Intuition · Mode d'emploi
Pour chaque pourcentage, écris d'abord le groupe de référence. Une fraction correctement nommée vaut mieux qu'un calcul rapide dont le dénominateur reste mystérieux.
Exercice 1 ★☆☆ : Reconnaître les variables
On interroge 80 foyers sur leur type principal de chauffage, leur degré de satisfaction (faible , moyen , élevé ) et leur facture mensuelle d'énergie.
Identifier la population, un individu et les trois variables. Pour chacune, préciser si elle est qualitative nominale, qualitative ordinale ou quantitative.
Exercice 2 ★☆☆ : Compléter avec les marges
Compléter le tableau et expliquer chaque soustraction.
\(B\) \(\overline B\) Total \(A\) 36 ? 60 \(\overline A\) 24 16 40 Total 60 40 100
Exercice 3 ★☆☆ : Fréquences globales et marginales
Reprendre le tableau « transport et ponctualité » du cours.
Calculer la fréquence des transports actifs.
Calculer la fréquence des élèves à l'heure.
Calculer la fréquence des élèves à la fois actifs et en retard.
Calculer la fréquence des transports motorisés.
Exercice 4 ★☆☆ : Le bon dénominateur
Toujours avec le tableau du cours, calculer et interpréter :
\[f_A(H),\qquad f_H(A),\qquad f_M(H),\]
où \(A\) signifie « transport actif », \(M\) « transport motorisé » et \(H\) « à l'heure ».
Exercice 5 ★☆☆ : Traduire en français
Dans le tableau du cours, expliquer précisément ce que représentent les fractions
\[\frac{12}{70},\qquad \frac{12}{36},\qquad \frac{24}{160}.\]
Pour chaque fraction, dire s'il s'agit d'une fréquence conditionnelle ou globale.
Exercice 6 ★★☆ : Un tableau conditionnel
Construire le tableau des fréquences de ponctualité conditionnelles au mode de transport. Chaque colonne devra totaliser 100 %. Arrondir au dixième de pourcentage et commenter la principale différence.
Exercice 7 ★★☆ : Retrouver les effectifs
Une plateforme compte 600 clients, dont 240 abonnés. Parmi les abonnés, 35 % choisissent l'option premium. Au total, 150 clients ont choisi cette option.
Construire le tableau croisant abonnement et option premium.
Calculer la fréquence du premium parmi les non-abonnés.
Comparer les deux groupes en points de pourcentage.
Exercice 8 ★★☆ : Points ou pourcentage relatif ?
Dans le groupe X, 72 % des personnes répondent « oui », contre 60 % dans le groupe Y.
Calculer l'écart en points de pourcentage.
Calculer l'augmentation relative de 60 % à 72 %.
Expliquer pourquoi les réponses 12 % et 20 % ne décrivent pas la même comparaison.
Exercice 9 ★★☆ : ET, OU, NON
Parmi 160 élèves, 50 utilisent un transport actif, 124 arrivent à l'heure et 42 vérifient les deux critères.
Combien utilisent un transport actif ou arrivent à l'heure ?
Combien ne vérifient aucun des deux critères ?
Expliquer pourquoi \(50+124\) ne répond pas directement à la première question.
Exercice 10 ★★☆ : Passer de listes à un tableau
On dispose des listes suivantes, dans lesquelles les éléments de même rang concernent la même personne.
groupe = ["A", "B", "A", "A", "B", "B", "A", "B"]
choix  = ["oui", "non", "oui", "non",
          "oui", "oui", "non", "non"]
Construire le tableau croisé d'effectifs.
Calculer les fréquences de « oui » dans les deux groupes.
Les variables semblent-elles associées dans ces huit données ?
Exercice 11 ★★☆ : Une fréquence conditionnelle impose une case
Une enquête porte sur 400 personnes. Le groupe \(A\) contient 150 personnes et
\[f_A(B)=28\,\%.\]
Au total, 100 personnes vérifient \(B\) .
Construire entièrement le tableau croisant \(A/\overline A\) et \(B/\overline B\) .
Sur 1 000 personnes, 100 sont malades. Le tableau d'observation est :
Test positif Test négatif Total Malade 90 10 100 Non malade 45 855 900 Total 135 865 1 000
Parmi les malades, quelle est la fréquence des tests positifs ?
Parmi les non-malades, quelle est la fréquence des tests négatifs ?
Parmi les tests positifs, quelle est la fréquence des personnes malades ?
Pourquoi les réponses aux questions 1 et 3 sont-elles différentes ?
Exercice 13 ★★★ : Indépendance dans un tableau
On considère le tableau
\[\begin{array}{c|cc|c}
& B & \overline B & \text{Total}\\ \hline
A & 30 & 20 & 50\\
\overline A & x & 40 & x+40
\end{array}.\]
Déterminer \(x\) pour que la fréquence de \(B\) soit la même dans les deux lignes. Vérifier ensuite le critère \(ad=bc\) .
Exercice 14 ★★★ : Une moyenne pondérée de proportions
Un premier site compte 200 personnes et un taux de réponse de 75 %. Un second site compte 300 personnes et un taux de réponse de 60 %.
Calculer le taux global de réponse de deux façons : avec les effectifs, puis avec une moyenne pondérée. Expliquer pourquoi la moyenne simple de 75 % et 60 % ne convient pas.
Exercice 15 ★★★ : Retrouver une fréquence conditionnelle
La population est partagée entre \(A\) et \(\overline A\) . On sait que
\[f(B)=0{,}54,\qquad f(A)=0{,}40,\qquad f_A(B)=0{,}75.\]
Montrer que
\[f(B)=f(A)f_A(B)+\bigl(1-f(A)\bigr)f_{\overline A}(B).\]
En déduire \(f_{\overline A}(B)\) .
Interpréter la différence entre les deux fréquences conditionnelles.
Problème défi : évaluer un programme de tutorat Intuition · Objectif
Ce problème montre pourquoi un taux global peut donner une conclusion opposée aux comparaisons détaillées. Toutes les questions sont guidées : les calculs simples construisent progressivement l'explication.
Un lycée étudie la réussite de 230 élèves à une évaluation. Certains ont suivi un tutorat. Les élèves sont également classés selon leur niveau initial : groupe 1 ou groupe 2 .
Groupe initial 1 Réussite Échec Total Avec tutorat 18 2 20 Sans tutorat 80 20 100 Total 98 22 120
Groupe initial 2 Réussite Échec Total Avec tutorat 60 40 100 Sans tutorat 5 5 10 Total 65 45 110
Partie A - Construire la vue d'ensemble
Identifier la population et les trois variables observées. Préciser leur nature.
Vérifier les totaux des deux tableaux.
Construire le tableau croisant seulement tutorat et réussite, sans distinguer le niveau initial.
Calculer les fréquences marginales du tutorat et de la réussite.
Calculer la fréquence de réussite parmi les élèves tutorés.
Calculer la fréquence de réussite parmi les élèves non tutorés.
Quelle conclusion naïve donnerait la seule comparaison globale ?
Partie B - Comparer à niveau initial fixé
Dans le groupe initial 1, calculer les taux de réussite avec et sans tutorat.
Dans le groupe initial 2, calculer les taux de réussite avec et sans tutorat.
Comparer ces résultats avec la conclusion de la question 7.
Nommer le phénomène observé.
Partie C - Comprendre le renversement
Parmi les élèves tutorés, calculer la fréquence du groupe initial 2.
Parmi les élèves non tutorés, calculer la fréquence du groupe initial 2.
Expliquer en quoi la composition des groupes est très différente.
Retrouver le taux global de réussite des tutorés comme moyenne pondérée de 90 % et 60 %.
Faire le même travail pour les non-tutorés avec 80 % et 50 %.
Partie D - Comparer avec les mêmes poids
Calculer le taux standardisé des tutorés en donnant un poids \(1/2\) à chaque niveau.
Calculer de même le taux standardisé des non-tutorés.
Comparer ces deux taux en points de pourcentage.
Pourquoi cette standardisation est-elle plus équitable pour comparer les groupes ?
Partie E - Généraliser et garder un esprit critique
On note \(S\) le groupe initial 1, \(F\) le groupe initial 2, \(T\) le tutorat et \(R\) la réussite.
Montrer que
\[f_T(R)=f_T(S)f_{T\cap S}(R)+f_T(F)f_{T\cap F}(R).\]
Expliquer comment des poids très différents peuvent renverser la comparaison globale.
Peut-on conclure que le tutorat cause une meilleure réussite ? Rédiger une réponse prudente et proposer une information supplémentaire utile.
Attention · Avant le corrigé
Dans chaque fraction, vérifie le groupe de référence. Une phrase comme « 60 % réussissent » est incomplète tant que l'on ne sait pas parmi quels élèves.
Corrigés détaillés Corrigé 1
Démonstration · Nommer ce qui est observé
La population est l'ensemble des 80 foyers interrogés ; un individu est l'un de ces foyers.
Le type principal de chauffage est qualitatif nominal : gaz, électricité, bois, etc. ne sont pas naturellement ordonnés.
Le degré de satisfaction est qualitatif ordinal : faible \(<\) moyen \(<\) élevé.
La facture mensuelle est quantitative. Enregistrée au centime, elle prend des valeurs discrètes, multiples de \(0{,}01\) euro ; on peut éventuellement utiliser une approximation continue dans un modèle annoncé.
Corrigé 2
Démonstration · Soustraire au total
Dans la ligne de \(A\) , la case manquante vaut
\[60-36=\boxed{24}.\]
On contrôle avec la colonne de \(\overline B\) :
\[24+16=40.\]
Les deux marges donnent bien \(60+40=100\) .
\(B\) \(\overline B\) Total \(A\) 36 24 60 \(\overline A\) 24 16 40 Total 60 40 100
Corrigé 3
Démonstration · Le total \(N=160\) est le dénominateur
Les quatre fréquences demandées sont globales ou marginales : le dénominateur est donc toujours 160.
\[\begin{aligned}f(A) &= \frac{50}{160}\\[.35em]&= \boxed{31{,}25\,\%},\\[.35em]f(H) &= \frac{124}{160}\\[.35em]&= \boxed{77{,}5\,\%}.\end{aligned}\]
\[f(A\cap\overline H)=\frac8{160}=\boxed{5\,\%},
\qquad
f(M)=\frac{40}{160}=\boxed{25\,\%}.\]
Corrigé 4
Démonstration · Lire le symbole de gauche à droite
\[\begin{aligned}f_A(H) &= \frac{\operatorname{Card}(A\cap H)}{\operatorname{Card}(A)}\\[.35em]&= \frac{42}{50}\\[.35em]&= \boxed{84\,\%}.\end{aligned}\]
Parmi les utilisateurs d'un transport actif, 84 % sont ponctuels.
\[\begin{aligned}f_H(A) &= \frac{42}{124}\\[.35em]&\approx \boxed{33{,}9\,\%}.\end{aligned}\]
Parmi les élèves ponctuels, environ 33,9 % utilisent un transport actif.
\[\begin{aligned}f_M(H) &= \frac{24}{40}\\[.35em]&= \boxed{60\,\%}.\end{aligned}\]
Parmi les utilisateurs d'un transport motorisé, 60 % sont ponctuels.
Corrigé 5
Démonstration · Le dénominateur révèle la question
\(12/70\approx17{,}1\,\%\) : parmi les 70 élèves en transports en commun, 12 sont en retard. C'est une fréquence conditionnelle.
\(12/36\approx33{,}3\,\%\) : parmi les 36 élèves en retard, 12 utilisent les transports en commun. C'est l'autre conditionnement.
\(24/160=15\,\%\) : dans toute la population, 24 élèves sont motorisés et ponctuels. C'est une fréquence globale d'intersection.
Les deux premières fractions ont le même numérateur 12, mais elles répondent à deux questions différentes.
Corrigé 6
Démonstration · Chaque colonne totalise 100 %
Actif Transports Motorisé À l'heure \(84{,}0\,\%\) \(82{,}9\,\%\) \(60{,}0\,\%\) En retard \(16{,}0\,\%\) \(17{,}1\,\%\) \(40{,}0\,\%\) Total \(100\,\%\) \(100\,\%\) \(100\,\%\)
Dans ces données, le taux de ponctualité du groupe motorisé est inférieur de 24 points à celui du groupe actif et d'environ 22,9 points à celui des transports en commun. Cela décrit une association, pas une cause.
Corrigé 7
Démonstration · Du pourcentage à la case
Parmi les 240 abonnés, l'effectif premium vaut
\[0{,}35\times240=84.\]
Comme il y a 150 clients premium au total, \(150-84=66\) ne sont pas abonnés. On complète par soustraction.
Premium Standard Total Abonnés 84 156 240 Non-abonnés 66 294 360 Total 150 450 600
Parmi les non-abonnés,
\[\frac{66}{360}\approx\boxed{18{,}3\,\%}\]
choisissent le premium. L'écart avec les abonnés vaut
\[35-18{,}3=\boxed{16{,}7\ \text{points environ}}.\]
Corrigé 8
Démonstration · Deux comparaisons correctes mais différentes
L'écart absolu entre les proportions vaut
\[72\,\%-60\,\%=\boxed{12\ \text{points de pourcentage}}.\]
L'augmentation relative, en prenant 60 % comme valeur de départ, vaut
\[\begin{aligned}\frac{72-60}{60} &= \frac{12}{60}\\[.35em]&= 0{,}20\\[.35em]&= \boxed{20\,\%}.\end{aligned}\]
Les 12 points comparent directement deux proportions. Les 20 % indiquent que l'écart 12 représente un cinquième de la proportion de départ 60.
Corrigé 9
Démonstration · Éviter le double comptage
\[\begin{aligned}\operatorname{Card}(A\cup H) &= \operatorname{Card}(A) +\operatorname{Card}(H)\\[.35em]&\quad {}-\operatorname{Card}(A\cap H).\end{aligned}\]
Ainsi,
\[\begin{aligned}\operatorname{Card}(A\cup H) &= 50+124-42\\[.35em]&= \boxed{132}.\end{aligned}\]
Il reste
\[160-132=\boxed{28}\]
élèves qui ne sont ni actifs ni ponctuels. Dans \(50+124\) , les 42 élèves de l'intersection sont comptés deux fois : on les retire une fois.
Corrigé 10
Démonstration · Compter les couples
Les couples observés donnent :
Oui Non Total Groupe A 2 2 4 Groupe B 2 2 4 Total 4 4 8
Dans chaque groupe, la fréquence de « oui » vaut \(2/4=\boxed{50\,\%}\) . Les distributions conditionnelles sont identiques dans ces huit données : aucune association n'y apparaît. Avec un si petit effectif, cette conclusion reste très fragile.
Corrigé 11
Démonstration · Appliquer 28 % au bon groupe
Le groupe \(A\) contient 150 personnes. Donc
\[\begin{aligned}\operatorname{Card}(A\cap B) &= 0{,}28\times150\\[.35em]&= \boxed{42}.\end{aligned}\]
Il y a alors \(150-42=108\) personnes de \(A\) dans \(\overline B\) . Comme \(B\) contient 100 personnes au total, \(100-42=58\) sont dans \(\overline A\cap B\) . Enfin, \(\overline A\) contient \(400-150=250\) personnes, donc \(250-58=192\) sont dans \(\overline A\cap\overline B\) .
\(B\) \(\overline B\) Total \(A\) 42 108 150 \(\overline A\) 58 192 250 Total 100 300 400
Corrigé 12
Démonstration · Ne jamais inverser le conditionnement
Parmi les malades, la fréquence des tests positifs est
\[\frac{90}{100}=\boxed{90\,\%}.\]
Parmi les non-malades, la fréquence des tests négatifs est
\[\frac{855}{900}=\boxed{95\,\%}.\]
Mais parmi les tests positifs, la fréquence des personnes malades vaut
\[\begin{aligned}\frac{90}{135} &= \frac23\\[.35em]&\approx \boxed{66{,}7\,\%}.\end{aligned}\]
La première fraction conditionne par « malade » ; la troisième par « test positif ». Le numérateur 90 est identique, mais les groupes de référence, 100 et 135, diffèrent. La fréquence de la maladie dans la population intervient donc dans la composition du groupe des tests positifs.
Corrigé 13
Démonstration · Égaliser les deux fréquences
La fréquence de \(B\) dans la première ligne vaut
\[\frac{30}{30+20}=\frac35.\]
On veut donc
\[\frac{x}{x+40}=\frac35.\]
Le produit en croix donne \(5x=3x+120\) , donc
\[\boxed{x=60}.\]
Avec
\[a=30,\]
\[b=20,\]
\[c=60\]
\[\text{et }d=40,\]
\[ad=30\times40=1200
\qquad\text{et}\qquad
bc=20\times60=1200.\]
Le critère \(ad=bc\) est vérifié.
Corrigé 14
Démonstration · Pondérer par les tailles
Le premier site fournit \(0{,}75\times200=150\) réponses ; le second en fournit \(0{,}60\times300=180\) . Le taux global est donc
\[\begin{aligned}\frac{150+180}{200+300} &= \frac{330}{500}\\[.35em]&= \boxed{66\,\%}.\end{aligned}\]
Avec une moyenne pondérée,
\[\begin{aligned}\frac{200}{500}\times75\,\%+\frac{300}{500}\times60\,\% &= 30\,\%+36\,\%\\[.35em]&= 66\,\%.\end{aligned}\]
La moyenne simple \(67{,}5\,\%\) donnerait le même poids aux deux sites alors que le second est plus grand.
Corrigé 15
Démonstration · Décomposer selon \(A\) et \(\overline A\)
Les ensembles \(A\) et \(\overline A\) forment une partition. La formule de moyenne pondérée donne
\[f(B)=f(A)f_A(B)+f(\overline A)f_{\overline A}(B),\]
avec \(f(\overline A)=1-f(A)\) . En notant \(x=f_{\overline A}(B)\) ,
\[0{,}54=0{,}40\times0{,}75+0{,}60x.\]
Ainsi,
\[0{,}54=0{,}30+0{,}60x,
\qquad
x=\frac{0{,}24}{0{,}60}=\boxed{0{,}40}.\]
La fréquence de \(B\) vaut 75 % parmi \(A\) , contre 40 % parmi \(\overline A\) , soit un écart de 35 points. Dans ces données, les variables sont donc fortement associées.
Corrigé du problème défi Partie A - Vue d'ensemble
Démonstration · Questions 1 à 7
1. La population est constituée des 230 élèves. Les trois variables sont le suivi du tutorat (oui/non), le niveau initial (groupe 1/groupe 2) et le résultat (réussite/échec). Elles sont toutes qualitatives ; le niveau initial peut être considéré comme ordinal.
2. Pour le groupe initial 1, \(18+2+80+20=120\) . Pour le groupe initial 2, \(60+40+5+5=110\) . On retrouve \(120+110=230\) élèves.
3. On additionne les deux niveaux case par case.
Réussite Échec Total Avec tutorat 78 42 120 Sans tutorat 85 25 110 Total 163 67 230
4. Les fréquences marginales principales sont
\[\begin{aligned}f(T) &= \frac{120}{230}\\[.35em]&\approx \boxed{52{,}2\,\%},\\[.35em]f(R) &= \frac{163}{230}\\[.35em]&\approx \boxed{70{,}9\,\%}.\end{aligned}\]
5. Parmi les élèves tutorés,
\[\begin{aligned}f_T(R) &= \frac{78}{120}\\[.35em]&= \boxed{65\,\%}.\end{aligned}\]
6. Parmi les élèves non tutorés,
\[\begin{aligned}f_{\overline T}(R) &= \frac{85}{110}\\[.35em]&\approx \boxed{77{,}3\,\%}.\end{aligned}\]
7. Une lecture globale naïve dirait que le groupe sans tutorat réussit davantage, avec environ 12,3 points de plus. Cette phrase décrit le tableau global mais ne tient pas compte du niveau initial.
Partie B - Comparaison à niveau fixé
Démonstration · Questions 8 à 11
8. Dans le groupe initial 1,
\[\begin{aligned}f_{T\cap S}(R) &= \frac{18}{20}\\[.35em]&= \boxed{90\,\%},\\[.35em]f_{\overline T\cap S}(R) &= \frac{80}{100}\\[.35em]&= \boxed{80\,\%}.\end{aligned}\]
Le taux tutoré est supérieur de 10 points.
9. Dans le groupe initial 2,
\[\begin{aligned}f_{T\cap F}(R) &= \frac{60}{100}\\[.35em]&= \boxed{60\,\%},\\[.35em]f_{\overline T\cap F}(R) &= \frac5{10}\\[.35em]&= \boxed{50\,\%}.\end{aligned}\]
Le taux tutoré est encore supérieur de 10 points.
10. Dans chaque niveau, le tutorat est associé à un taux supérieur ; pourtant, dans l'ensemble, son taux est inférieur. La comparaison globale est donc renversée.
11. Ce phénomène s'appelle le paradoxe de Simpson . Il ne s'agit pas d'une contradiction : les groupes globaux n'ont pas la même composition.
Partie C - Composition et pondération
Démonstration · Questions 12 à 16
12. Parmi les tutorés,
\[\begin{aligned}f_T(F) &= \frac{100}{120}\\[.35em]&\approx \boxed{83{,}3\,\%}.\end{aligned}\]
13. Parmi les non-tutorés,
\[\begin{aligned}f_{\overline T}(F) &= \frac{10}{110}\\[.35em]&\approx \boxed{9{,}1\,\%}.\end{aligned}\]
14. Le groupe tutoré est composé en très grande majorité d'élèves du second groupe initial, dont les taux de réussite sont plus faibles dans les deux situations. Le groupe non tutoré contient surtout des élèves de groupe initial 1. Cette différence de composition pèse fortement sur les taux globaux.
15. Pour les tutorés,
\[\begin{aligned}\frac{20}{120}\times90\,\%+\frac{100}{120}\times60\,\% &= 15\,\%+50\,\%\\[.35em]&= \boxed{65\,\%}.\end{aligned}\]
16. Pour les non-tutorés,
\[\begin{aligned}\frac{100}{110}\times80\,\%+\frac{10}{110}\times50\,\% &= \frac{80+5}{110}\\[.35em]&\approx \boxed{77{,}3\,\%}.\end{aligned}\]
Les poids associés aux niveaux standard et fragile sont presque inversés entre les deux groupes.
Partie D - Standardisation
Démonstration · Questions 17 à 20
17. Avec un poids \(1/2\) pour chaque niveau,
\[\frac12\times90\,\%+\frac12\times60\,\%=\boxed{75\,\%}.\]
18. Pour les non-tutorés,
\[\frac12\times80\,\%+\frac12\times50\,\%=\boxed{65\,\%}.\]
19. L'écart standardisé vaut
\[75\,\%-65\,\%=\boxed{10\ \text{points de pourcentage}}.\]
20. Les deux taux utilisent maintenant exactement les mêmes poids pour les niveaux. La différence ne provient donc plus du fait que l'un des groupes contient davantage d'élèves du second groupe initial. La comparaison est plus équitable sur ce facteur précis, mais d'autres différences peuvent encore exister.
Partie E - Généralisation et prudence
Démonstration · Questions 21 à 23
21. Les tutorés sont partagés entre \(T\cap S\) et \(T\cap F\) . La formule de décomposition donne
\[f_T(R)
=f_T(S)f_{T\cap S}(R)+f_T(F)f_{T\cap F}(R).\]
Numériquement,
\[\begin{aligned}\frac{20}{120}\times\frac{18}{20}
+\frac{100}{120}\times\frac{60}{100} &= \frac{18+60}{120}\\[.35em]&= \frac{78}{120}.\end{aligned}\]
22. Un taux global est une moyenne pondérée. Même si chacun des deux taux tutorés est supérieur au taux non tutoré correspondant, un poids très fort sur le groupe initial 2 peut faire baisser la moyenne tutorée sous l'autre moyenne globale.
23. On ne peut pas conclure à une causalité : les élèves n'ont peut-être pas été répartis au hasard, et le tutorat a pu être proposé prioritairement aux élèves les plus en difficulté. Il serait utile de disposer de scores initiaux plus précis, d'autres caractéristiques pertinentes ou, si le cadre le permet, d'une comparaison construite avec des groupes initialement comparables.
Fiche-mémoire Agrandir ↗ Définition · Tableau croisé
Une case intérieure représente une intersection. Les marges sont les totaux des lignes et colonnes.
Définition · Fréquence globale
\[f(A\cap B)=\frac{n(A\cap B)}{N}.\]
Le dénominateur est toute la population.
Définition · Fréquence marginale
\[f(A)=\frac{n(A)}{N}.\]
Elle se lit dans une marge du tableau.
Méthode · ET, OU, NON
\[\text{ET}\leftrightarrow\cap,\quad
\text{OU}\leftrightarrow\cup,\quad
\text{NON }A\leftrightarrow\overline A.\]
Définition · Fréquence conditionnelle
\[f_A(B)=\frac{n(A\cap B)}{n(A)}.\]
« Parmi \(A\) » signifie que \(A\) fournit le dénominateur.
Méthode · Décomposition
Si les \(A_i\) forment une partition,
\[f(B)=\sum_i f(A_i)f_{A_i}(B).\]
C'est une moyenne pondérée.
Méthode · Comparer
calcule les taux de chaque groupe ;
compare en points de pourcentage ;
précise « dans ces données » ;
ne conclus pas automatiquement à une cause.
Méthode · Indépendance observée
Dans un tableau \(2\times2\) , mêmes distributions conditionnelles
\[\ssi ad=bc.\]
Attention · Les quatre pièges
Inverser \(f_A(B)\) et \(f_B(A)\) ; diviser par \(N\) quand la question dit « parmi » ; comparer des effectifs lorsque les groupes n'ont pas la même taille ; transformer une association en causalité.
Réflexe final : écris le groupe de référence avant chaque calcul. Le dénominateur devient alors presque toujours évident.
Maîtrise du chapitre
Validation contrôlée
Réponds aux QCM, sélectionne les bonnes propositions ou remets les étapes dans l'ordre. Le site vérifie chaque réponse avant d'ouvrir la balise suivante.
Parcours de maîtrise
Entraînement libre
Active JavaScript pour utiliser les quizlets interactifs.
Mes révisions Choisir un exercice Signaler une erreur Chapitre précédent ← Statistiques à une variable Chapitre suivant Probabilités conditionnelles et arbres →